GPT Image 2 是什么?OpenAI 最新图像模型完全指南
深度解读 GPT Image 2(OpenAI gpt-image-2 模型):发布时间、核心能力(照片级真实感、精准文字渲染、4K 输出、应用场景)、API 价格、提示词工程技巧,以及与 DALL·E 3、gpt-image-1.5、Midjourney 等主流图像模型的横向对比,帮你判断是否切换工作流。
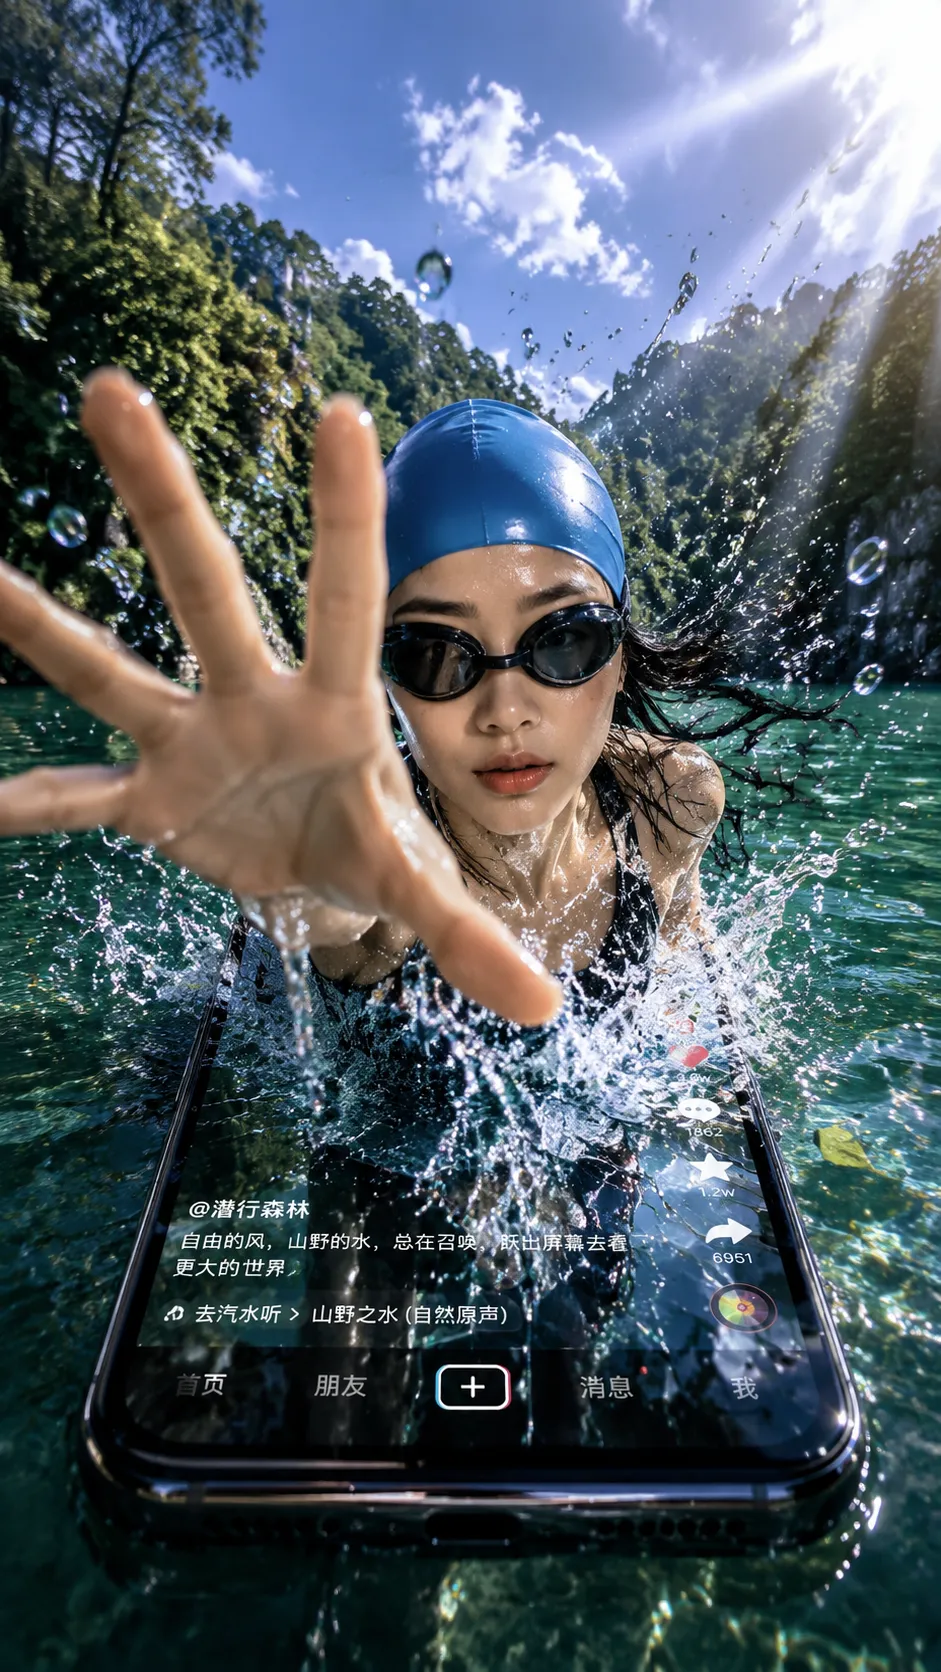
GPT Image 2(也写作 gpt-image-2)是 OpenAI 在 2026 年 4 月 21 日 正式发布的最新文生图模型,当前生产快照为 gpt-image-2-2026-04-21。作为 DALL-E 3 系列之后的旗舰图像模型,它在照片级真实感、文字渲染精度、多主体构图稳定性上都迈上了新台阶,同时把"图像内可读文字"这件事从"偶尔能用"提升到了"生产可用"。
本文将系统介绍它的能力边界、价格、提示词技巧,以及如何与同代模型横向对比。
一、GPT Image 2 解决了什么问题
早期扩散模型(Stable Diffusion 1.5、DALL-E 2、DALL-E 3)有三个长期痛点:
- 图像内文字不可读 — 招牌、标签、海报上的字母会变成意义不明的字符
- 多主体构图不稳定 — "红车在左、蓝摩托在右"经常被画成两辆颜色混淆的车
- 细节材质失真 — 手指、文字、瞳孔反射等细节经常出现瑕疵
GPT Image 2 通过把自回归语言模型与扩散解码器结合,让模型真正"理解"提示词中的语义结构再生成图像,从而同时解决了上面三个问题。这不是参数堆叠的小升级,而是架构上的代际跃迁。
二、核心能力一览
- 照片级真实感 — 肤色、布料材质、金属反射、玻璃通透度都接近真实拍摄
- 精准文字渲染 — 招牌、产品标签、UI 截图、海报标题都能清晰可读,支持中文、日文、阿拉伯文等非拉丁字母
- 强提示词遵循 — 长、详细、带结构化约束的提示词会被忠实执行
- 多主体构图稳定 — 多个人物、多个物体的相对位置、颜色、动作可分别指定
- 身份一致性(Identity) — 在编辑流中保持同一人物的脸部、服装、风格不变
- 多模态编辑 — 支持蒙版 inpainting、参考图融合、风格迁移
- 分辨率 — 原生支持 1024×1024、1024×1792(竖图)、1792×1024(横图),可二次放大到 4K
三、价格体系(2026 年 6 月最新)
OpenAI 采用 token 计费方式:
| 计费项 | 单价(美元 / 百万 token) |
|---|---|
| 输入(prompt + 参考图) | $8 |
| 缓存输入(cached input) | $2 |
| 输出(生成图像) | $30 |
折算到单张 1024×1024 图像的典型成本:
| 质量档位 | 单图参考价 |
|---|---|
| low(草图 / mockup) | 约 $0.006 |
| medium(社媒配图) | 约 $0.053 |
| high(广告物料) | 约 $0.211 |
low 档适合做大量探索性的草图迭代,high 档适合最终交付。两者之间相差约 35 倍,正确选择质量档位能显著控制成本。
四、常见应用场景
1. 营销与广告素材
营销团队用它批量生成广告变体、社媒配图、产品 mockup。精准的文字渲染意味着标题、CTA、品牌名可以直接出现在画面中,无需后期 Photoshop 修补。配合多主体稳定性,一次提示词就能产出"左侧产品 + 右侧文案 + 底部 CTA"的完整构图。
2. 职业形象照
求职者、远程团队、自媒体创作者用一张自拍 + 提示词描述(西装、白色背景、影棚光),几分钟就能生成一套风格统一的专业头像,省去预约摄影棚的成本。你可以直接在 GPT Image 2 AI 职业形象照生成器 中上传自拍体验这一玩法。
3. 概念设定与插画
插画师、游戏美术、小说作者用它做角色设计、场景氛围板、分镜草图。在委托正式插画之前先跑 10–20 张 AI 草图对齐方向,能极大降低沟通成本。
4. UI 与网页设计
设计师用它生成 hero 图、占位内容、落地页视觉参考。可嵌入可读文字的特性让它非常适合高保真 mockup —— 客户看到的不再是 Lorem Ipsum,而是接近成品的视觉。
5. 信息图与海报
需要把数据可视化嵌入海报时,GPT Image 2 可以同时处理图表与设计元素,并能保证标题、数据标签的可读性。
6. 多语言内容创作
支持中文、日文、韩文、阿拉伯文等非拉丁字符的精准渲染,让本地化营销物料、日漫风格插画、阿拉伯语海报都成为可能。
五、提示词工程:来自 OpenAI 官方 Cookbook 的建议
结构化模板
OpenAI 推荐按以下顺序组织提示词:
[背景/场景] → [主体] → [细节描述] → [约束条件]
把"背景"放在最前是为了让模型先建立空间,再填充主体;把"约束"(如画幅、风格、不要出现的元素)放在最后作为收束。
完整示例
现代极简风格的咖啡店吧台,
一位三十多岁的女性主厨正在装盘一道甜点,
她穿着米白色厨师服,头发束起,神情专注,
暖色窗光从左侧打入,50mm 镜头浅景深,
不要出现任何文字,不要出现顾客
五条高产出法则
- 具体优于华丽 — 避免"美丽"、"惊艳"这类模糊形容词,改为描述具体的视觉特征("窗光从左侧 45°打入"、"50mm 镜头浅景深")。
- 文字用引号或全大写 — 需要画面中出现文字时,用
"SUMMER SALE"这种全大写 + 引号的方式可以显著提升准确率。 - 拆分迭代,不要堆砌 — 一次提示词塞进 20 个细节容易顾此失彼。先生成基础构图,再用编辑(inpaint)逐步加细节。
- 指定质量杠杆 — 显式声明
quality: high用于最终交付,quality: low用于草图探索,能精准控制成本。 - 用参考图固定风格 — 通过参考图(reference image)能让一组输出共享同一种画风、同一个人物身份。
六、横向对比
| 模型 | 发布时间 | 图内文字 | 真实感 | 多主体稳定 | 典型价格(1024²) |
|---|---|---|---|---|---|
| GPT Image 2 | 2026-04 | 优秀 | 优秀 | 优秀 | $0.006 – $0.211 |
| gpt-image-1.5 | 2025-Q4 | 良好 | 优秀 | 良好 | 约 $0.04 – $0.19 |
| gpt-image-1 | 2025-04 | 良好 | 良好 | 一般 | 约 $0.02 – $0.17 |
| gpt-image-1-mini | 2025-04 | 一般 | 一般 | 一般 | 约 $0.001 – $0.04 |
| DALL-E 3 | 2023-10 | 良好 | 良好 | 一般 | 约 $0.04 – $0.12 |
| Midjourney v6 | 2024 | 一般 | 优秀 | 良好 | 订阅制 |
| Stable Diffusion 3 | 2024 | 一般 | 良好 | 良好 | 免费(自托管) |
结论:
- 追求 图内可读文字 和 多主体稳定 → GPT Image 2 是 2026 年唯一的首选
- 追求 极致艺术感 且不需要文字 → Midjourney v6 仍有优势
- 需要 完全可控、可自托管、可微调 → Stable Diffusion 3
- 大量草图探索、成本敏感 → gpt-image-1-mini
七、如何开始使用
我们的平台已经接入 GPT Image 2 最新快照,欢迎前往 GPT Image 2 在线图片生成器 免费体验。注册账号即可获赠免费积分,输入提示词、选择尺寸与质量档位后即可生成图像,完成后可下载原图或保存到历史记录。
小提示:初次使用建议先用 low 档位跑 5–10 张探索构图,确定方向后再切到 high 档位出最终稿,能在保证质量的同时把成本压到最低。
参考资料:
- OpenAI 官方公告:《Introducing GPT Image 2》(2026-04-21)
- OpenAI Cookbook:GPT Image 2 提示词工程指南
- OpenAI 定价页:platform.openai.com/pricing